Транскрибация — это перевод речи из аудиозаписи или видео в текст. В русском тот же процесс называют расшифровкой, а готовый текст — транскриптом. В независимом замере февраля 2026 года модель GigaAM v3 дала на русском WER 3,3%, Whisper large-v3-turbo — 7,9%, но через четыре месяца тот же автор получил результат, в котором разница между моделями исчезла. Ниже — чем термины отличаются от стенограммы, как читать проценты точности и чем расшифровывать аудио и видео.
Что такое транскрибация и чем она отличается от расшифровки и стенограммы
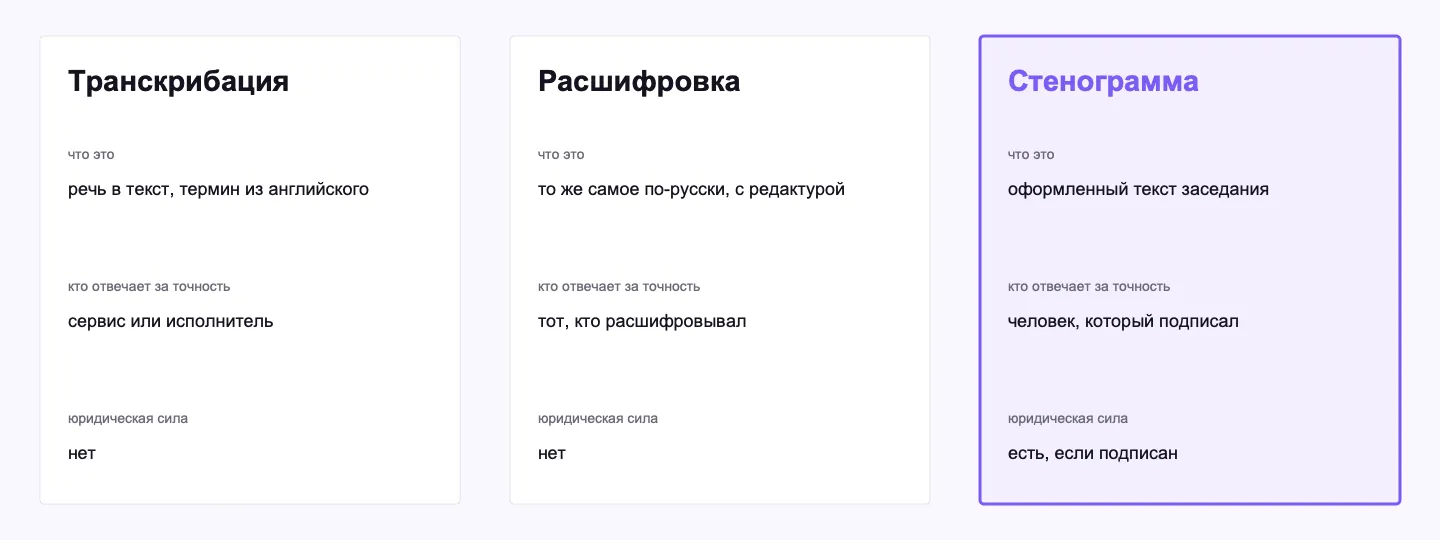
Транскрибация — это перевод речи в текст: в русском её же называют расшифровкой, а стенограммой — оформленный документ встречи, за содержание которого отвечает человек, а не модель. Разница между тремя словами не смысловая, а юридическая.
| Термин | Что это | Кто отвечает за точность | Юридическая сила |
|---|---|---|---|
| Транскрибация | процесс перевода речи в текст, заимствование из английского transcription | сервис или исполнитель, без гарантий | нет |
| Расшифровка | русское слово с тем же смыслом, часто подразумевает редактуру | тот, кто расшифровывал | нет |
| Стенограмма | оформленный текст заседания, слушания, переговоров | человек, который его подписал | есть, если документ оформлен и подписан |
Транскрибация — технический термин. На рынке сервисов под ней обычно понимают полный текст со знаками препинания и разметкой по спикерам, а не голый поток слов.
Расшифровка — русское слово с тем же значением. Оно старше AI: в судах расшифровщики перепечатывали кассеты, в академической среде — интервью полевых исследований. Слово несёт оттенок «приведения к читаемому виду»: убрать слова-паразиты, поправить имена собственные.
Стенограмма аудиозаписи — не синоним, а следующий шаг. Юридический вес ей даёт не качество распознавания, а человек, который поставил подпись и принял ответственность за текст. Машинная расшифровка стенограммой не становится сама по себе — ни при какой точности модели.
Есть и четвёртое слово — транскрипт: так называют итоговый файл с текстом. Транскрибация — процесс, транскрипт — результат. Сонар — сервис записи и расшифровки созвонов и голосовых на русском — отдаёт транскрипт в трёх форматах: PDF, Markdown и TXT.
Как работает автоматическая транскрибация
Любой сервис расшифровки делает четыре шага: сводит звук в моно 16 кГц, распознаёт речь моделью, размечает реплики по спикерам и собирает конспект языковой моделью. Пятого секретного шага у этой технологии нет.
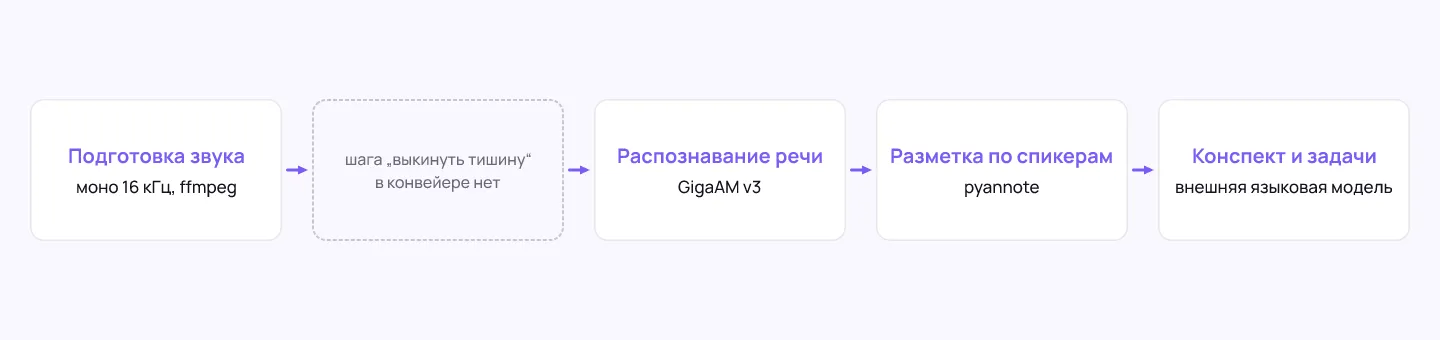
Шаг 1. Подготовка звука. Файл сводится в моно 16 кГц — в тот формат, который ждёт модель распознавания. Из видео звуковую дорожку вынимает ffmpeg, дальше работа идёт как с обычным аудио.
Шаг 2. Распознавание. Расшифровку в Сонаре делает GigaAM v3 — открытая российская модель Сбера, опубликованная 15 декабря 2025 года под лицензией MIT. Своя у нас не модель, а инфраструктура: сервер с видеокартой в России, на котором распознаётся речь и размечаются реплики.
Шаг 3. Разметка по спикерам. Диаризация аудио — отдельная нейросеть pyannote, которая размечает, кто говорит в каждый момент. Имена она не угадывает: спикеры различаются по голосу, подписывает их человек после расшифровки. Разметка по спикерам работает на платных тарифах, на бесплатном Старте она выключена.
Шаг 4. Конспект и задачи. Текст расшифровки уходит во внешнюю языковую модель: она собирает тезисы, договорённости и список задач. Во внешнюю модель уходит только текст, аудиофайл — нет.
Отдельного шага «выкинуть тишину» на сервере в этом конвейере нет — и его отсутствие ничего вам не стоит. Минуты тарифа списываются только за речь: тишина и паузы между репликами в счёт не идут — на всех тарифах, включая бесплатный.
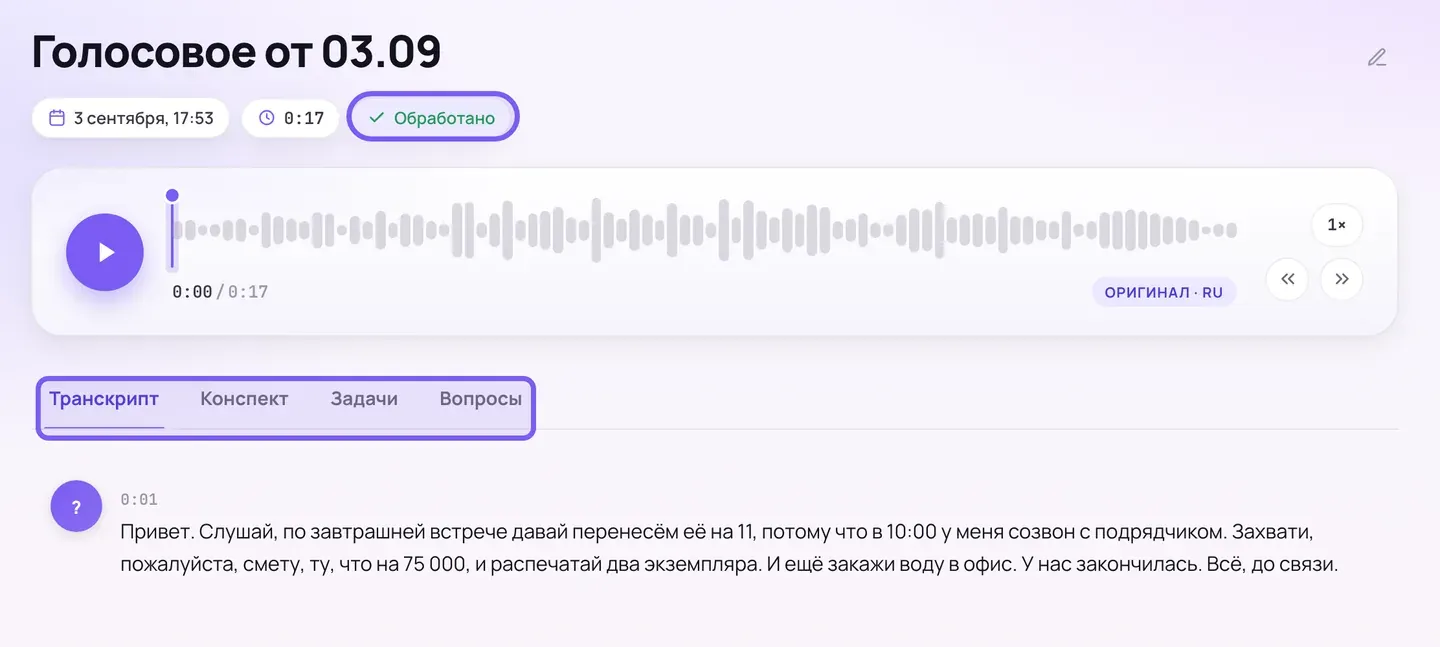
Из одной загрузки получаются три разных документа: транскрипт, конспект и список задач. Дальше по ним работает поиск: в кабинете есть раздел «Поиск» по словам во всех расшифровках, а в режиме «Спросить ИИ» вопрос задают всему архиву и получают ответ со ссылками на записи.
Что принимает сервис: форматы, длина, размер
Форматы аудио и видео у сервисов почти одинаковые, а предел одной загрузки у каждого свой: в Сонаре он зависит от тарифа — от 90 минут и 100 МБ на бесплатном Старте до 2000 МБ на Профи.
Сонар принимает аудио mp3, m4a, aac, wav, ogg, opus, oga, webm, flac, amr, wma, aiff, caf и видео mp4, m4v, mov, mkv, webm, avi — из видео берётся звуковая дорожка. Конвертировать заранее ничего не нужно: m4a с iPhone, ogg из мессенджера и mov из QuickTime грузятся как есть. Голосовые из мессенджеров — отдельный сценарий, он разобран в статье про то, как расшифровать голосовое из мессенджера.
Предел одной загрузки зависит от тарифа: Старт — 90 минут и 100 МБ, Рабочий — 4 часа и 500 МБ, Профи — без ограничения длины и до 2000 МБ. Жёсткий потолок сервера — 2 ГБ, тарифом он не снимается. Единого числа «файл до N часов» у продукта нет, и любой сервис, который называет одно такое число, скорее всего описывает один свой тариф.
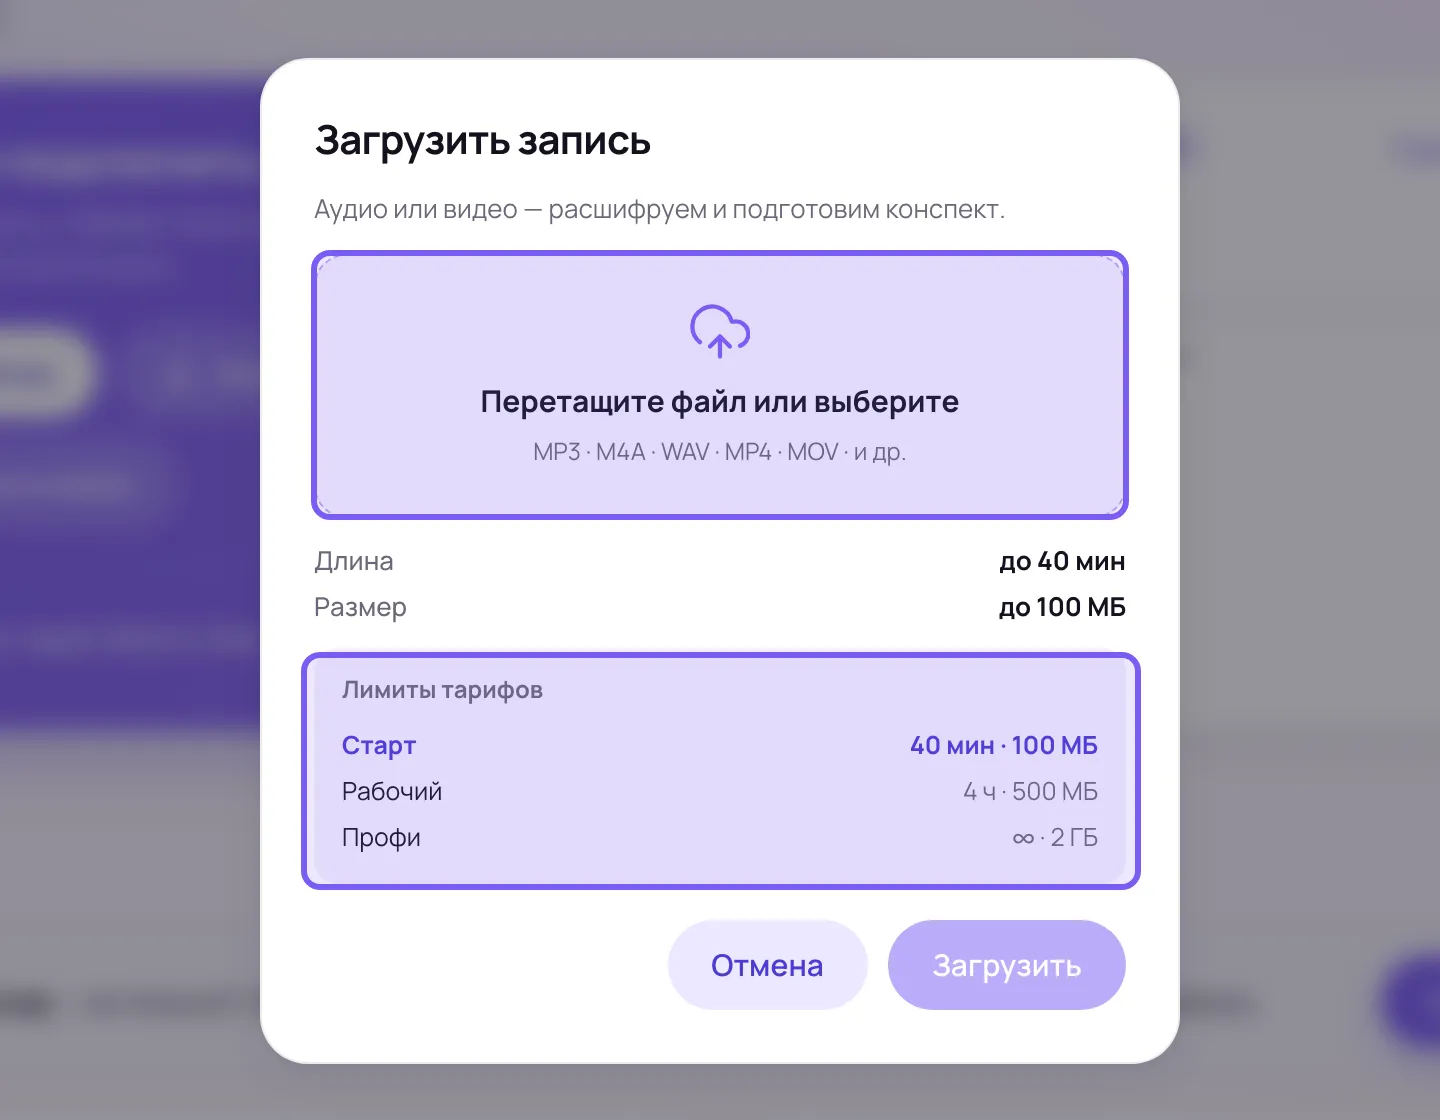
Предохранители по длине и размеру срабатывают только на загрузке готового файла. Живую запись с телефона, часов или из браузера по длине не обрывают — там работают месячные лимиты тарифа.
Язык распознавания — русский, и выбора языка у пользователя нет. Английские термины внутри русской речи модель разбирает в общем потоке, но для записи целиком на другом языке этот сервис не подходит.
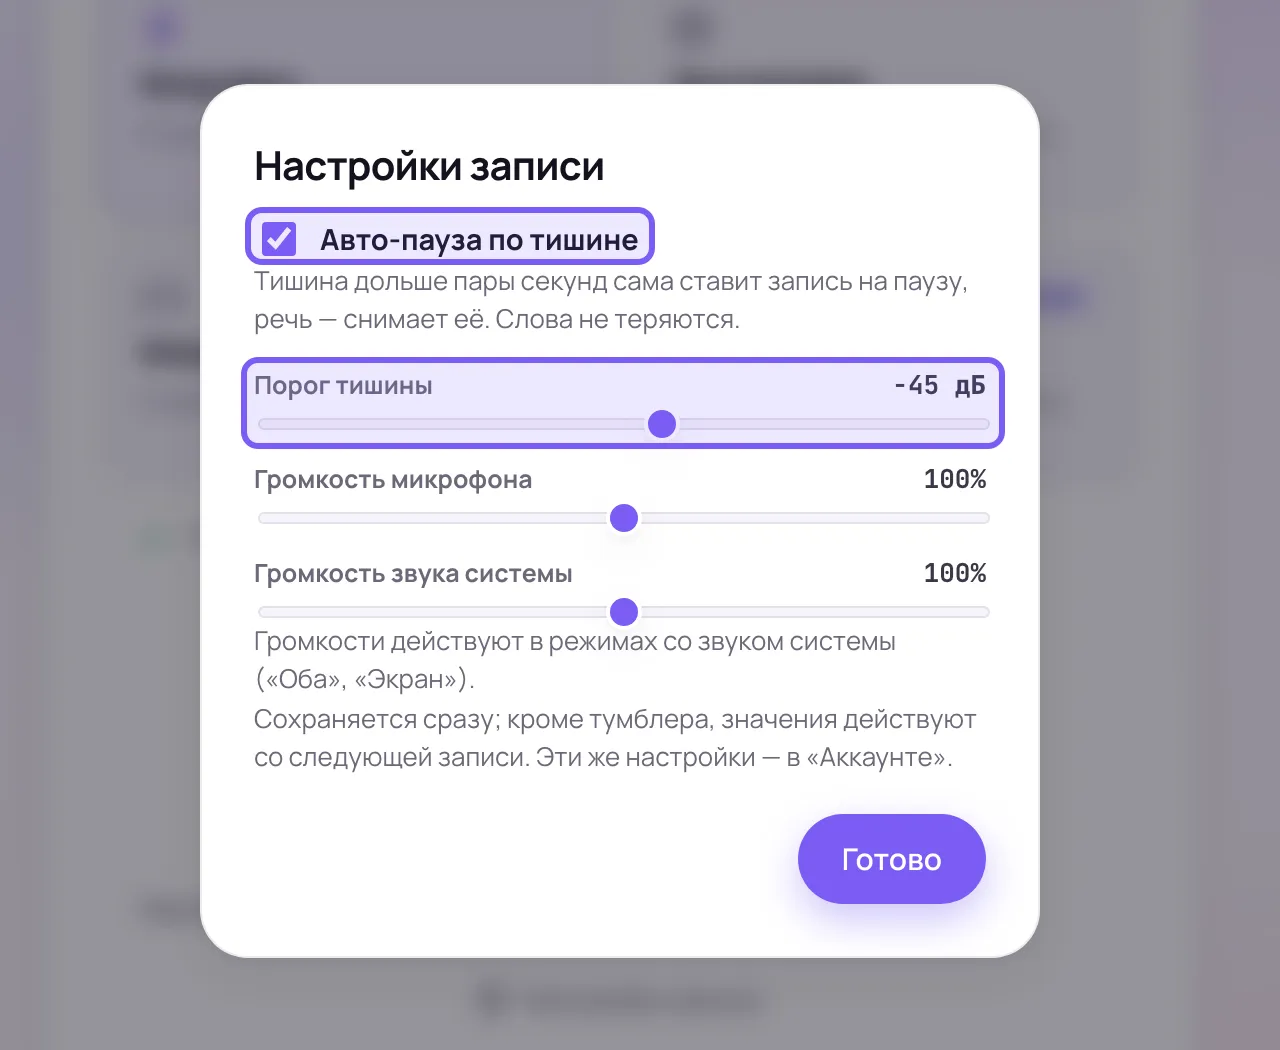
Когда вы записываете сами — с iPhone, с Apple Watch или из браузера в кабинете, — Сонар ставит запись на паузу, пока вокруг тишина, и продолжает, как только снова слышит речь. Тишина в файл не попадает, а начало фразы не обрезается. В приложении режим включается в настройках записи, в кабинете он работает сразу; порог тишины настраивается ползунком. Одна оговорка про браузер: пауза опирается на возможность браузера приостановить запись, и в Safari её нет — там запись идёт сплошным куском.
Точность на русском: что такое WER и почему чужим процентам нельзя верить
Точность распознавания меряют метрикой WER — долей ошибочных слов. В независимом замере февраля 2026 года GigaAM v3 дала на русском 3,3%, Whisper large-v3-turbo — 7,9%, Vosk — 13,0%.
WER (word error rate) считает, какая доля слов распознана неверно: чем ниже, тем лучше. Метрика складывает три типа ошибок — подмену слова, пропуск и лишнее слово. Число без указания модели, набора данных и условий записи не значит ничего, потому что все три множителя меняют результат сильнее, чем выбор бренда.
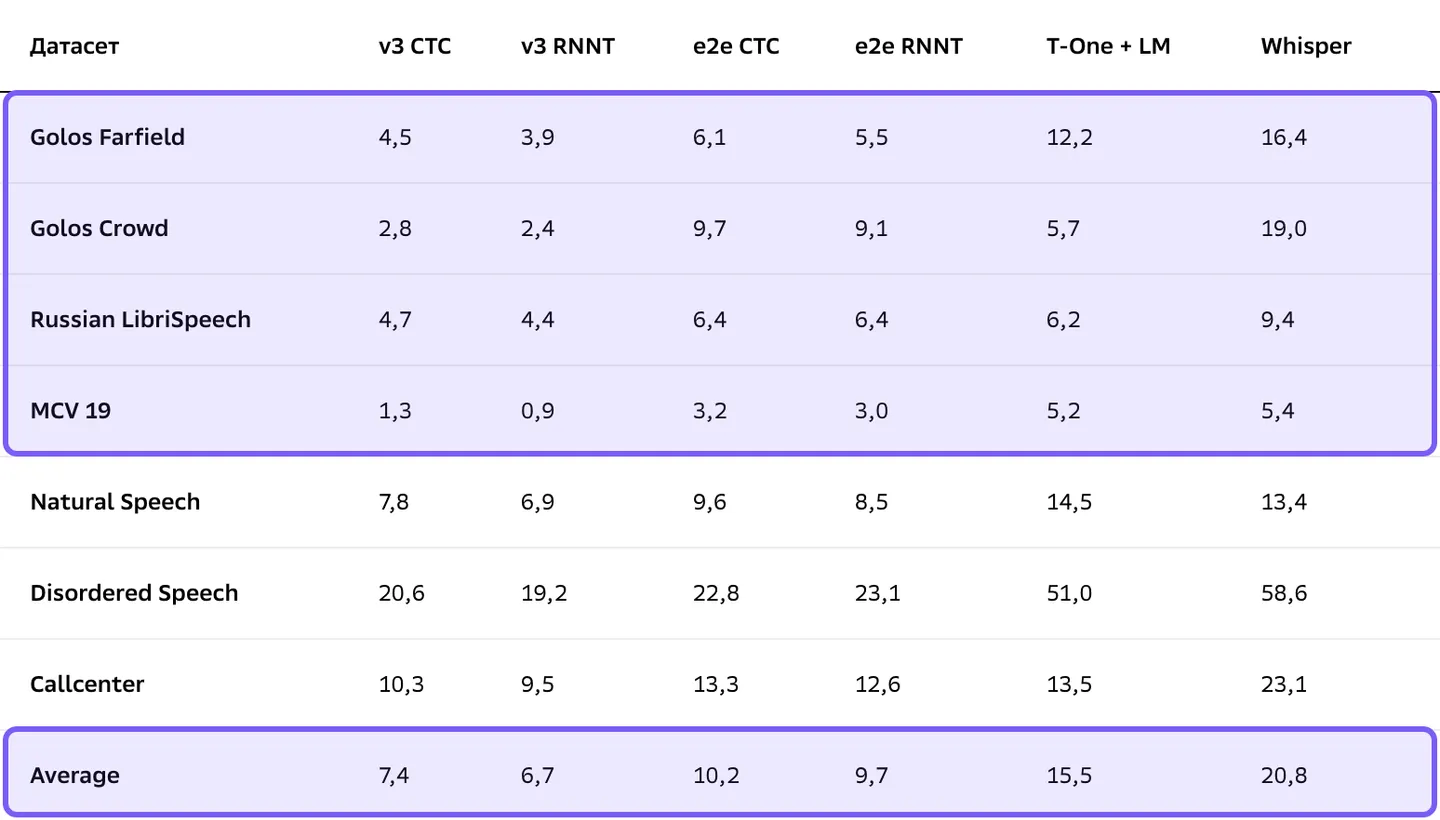
Разработчик модели и независимый исследователь считают разное. Сбер для линейки GigaAM v3 публикует средний WER 6,7% для варианта RNN-T и 7,4% для CTC — это строка Average по семи наборам данных, а по отдельным наборам разброс большой: 2,4% на Golos Crowd, 3,9% на Golos Farfield, 4,4% на Russian LibriSpeech, 0,9% на Common Voice (в таблице он подписан MCV 19). Одной цифры точности у модели просто нет — есть замер на конкретном наборе.
Отдельно стоит помнить, чего в источниках нет. В карточке модели openai/whisper-large-v3 на Hugging Face цифры WER по русскому языку нет вообще: там заявлено только снижение ошибок на 10-20% относительно large-v2. Все «8-12% у Whisper на русском», которые ходят по обзорам, к карточке модели отношения не имеют.
Почему цифрам точности из чужих обзоров нельзя верить
Тот же исследователь в июне 2026 повторил замер, и на студийной речи разрыв исчез: 7,28% против 7,89% — автор называет это статистическим паритетом; на записях с YouTube обе модели ушли за 26% ошибок. Февральский и июньский замеры сделал один человек с разницей в четыре месяца.
Причина расхождения — не в моделях. Автор объясняет её тремя вещами: предобработкой звука (автоматическая регулировка громкости и обрезка по тишине меняют WER на 6-9 процентных пунктов), несинхронизированными эталонными текстами и ошибками в самой разметке, по которой считают метрику. Выбор модели на этом фоне — не главный множитель.
Практический вывод простой: сравнивать движки надо на своих файлах, а не по чужой табличке. Запись из переговорки, интервью на улице и лекция в зале дают три разных результата на одной и той же модели.
Специализация тоже перевешивает общий рейтинг. Открытая российская модель T-one для телефонии на данных колл-центра даёт 8,63% против 19,39% у Whisper large-v3, а на общей речи разница обратная и почти незаметная: 5,78% против 5,32%. Модель, выигравшая в одном домене, в соседнем проигрывает.
Что портит WER на практике: шумный фон, сильный акцент, узкая терминология и редкие фамилии. Словарь терминов в Сонаре есть: вы заводите фамилии и слова — на Старте 5, на Рабочем 50, на Профи без лимита.
Чем расшифровывают: четыре типа решений
Решений четыре класса: облачный российский сервис, локальная открытая модель, API вендора и зарубежный сервис. Выбирают сначала класс, а внутри класса разница между брендами уже меньше, чем между классами.
| Класс решения | Что умеет | Где ломается | Кому подходит |
|---|---|---|---|
| Облачный российский сервис | загрузка файла, разметка по спикерам, конспект, архив с поиском, оплата рублями | вы доверяете запись стороннему оператору | регулярный поток встреч и интервью |
| Локальная открытая модель | распознавание на своём компьютере, ничего не уходит в сеть | нет интерфейса, архива и поиска, разметку по спикерам ставят отдельно | чувствительные записи, поток от нескольких десятков часов в месяц |
| API вендора | распознавание в чужом продукте, оплата по факту обработки | это не готовый сервис, а деталь — нужен разработчик | встраивание в свою систему |
| Зарубежный сервис | зрелый интерфейс, много интеграций с чужими сервисами | русская речь как второй класс, оплата картой другой юрисдикции, трансграничная передача данных | англоязычные команды |
Порядок в таблице — от самого частого выбора к самому редкому. Цены и бренды сознательно вынесены за скобки: они меняются каждый квартал, и живут в отдельном обзоре сервисов расшифровки с ценами. Из зарубежных чаще всего спрашивают про Otter — как он ведёт себя с русским, разобрано в статье про Otter AI на русском, а различия с глобальным ассистентом встреч — в сравнении с tl;dv. Два российских сервиса сравниваются в разборе Сонар и mymeet.
Локальный запуск бесплатен, но не невесом: сборка faster-whisper держит large-v3 примерно в 4,5 ГБ видеопамяти в режиме fp16, а с квантованием int8 считает и на процессоре. Это заметно скромнее, чем «нужен GPU и 10 ГБ под веса», которые кочуют по обзорам.
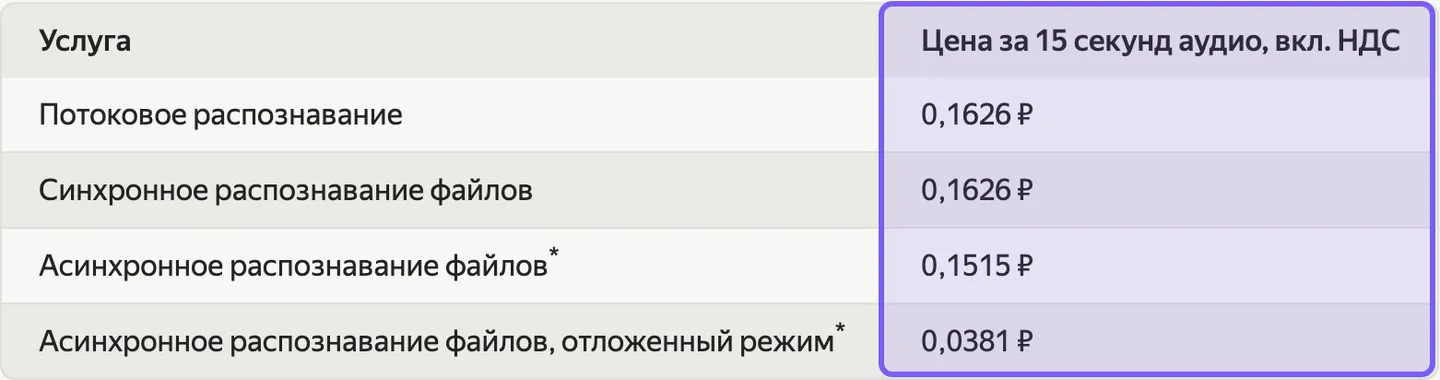
У API вендоров цена считается не так, как у розничных сервисов, и на этом легко ошибиться в десять раз. Yandex SpeechKit тарифицирует не секунду, а отрезок в 15 секунд: 0,1626 ₽ за отрезок в синхронном режиме и 0,0381 ₽ в отложенном (проверено 8 сентября 2026). Час записи — это 240 таких отрезков, то есть около 39 ₽ синхронно и около 9 ₽ в отложенном режиме; пересчёт в час здесь наш, вендор публикует цену за отрезок.
Транскрибация видео: YouTube, Rutube и локальные файлы
Видео расшифровывают так же, как аудио: сервис вынимает звуковую дорожку через ffmpeg и дальше работает с ней; Сонар принимает mp4, m4v, mov, mkv, webm и avi — шесть форматов видео на приёме.
YouTube. Если у ролика есть автосубтитры, их выгружают прямо из интерфейса или сторонним скриптом — расшифровка видео в текст в этом случае занимает минуту. Минус в том, что автосубтитры идут без разметки по спикерам и часто без знаков препинания, а имена и термины в них ломаются. Для интервью, лекции или экспертного разговора файл лучше прогнать через полноценный сервис.
Rutube, VK Видео, Дзен. Автосубтитров либо нет, либо они хуже. Порядок действий тот же: скачать файл (yt-dlp, десктопные загрузчики, расширения браузера) и загрузить его в сервис.
Локальные файлы. Запись с камеры iPhone, mov из QuickTime, webm из встроенной записи созвона — всё это грузится напрямую, без предварительной конвертации.
Сценарии, где расшифровка видео экономит часы: транскрипты экспертных интервью для подкастов, конспекты лекций, нарезка цитат для контента. Ручная перепечатка в них заменяется загрузкой файла и вычиткой готового текста.
Расшифровка созвонов: Телемост, Zoom, Google Meet
У созвонов другой путь: не «загрузить файл», а позвать в встречу бота. Бот Сонара заходит по ссылке в Яндекс Телемост, Zoom и Google Meet на платных тарифах — до 20 встреч в месяц на Рабочем и до 60 на Профи.
Дальше логика та же, что с загруженным файлом: распознавание, разметка по спикерам, конспект и задачи. Готовый транскрипт обычно приходит через несколько минут после конца встречи. В списке участников бот виден как «Sonar (запись)» — факт записи не прячется, и это же служит уведомлением для остальных участников.
Свои конспекты есть и у площадок. В Яндекс Телемосте работает конспект встречи от Алисы Про, но он доступен только организациям на тарифах Яндекс 360 — личный аккаунт вида login@yandex.ru его не получает, а записи хранятся 24 часа. Способы записи самого Телемоста, включая встроенную кнопку, разобраны в гайде как записать встречу в Телемосте.
Приватная транскрибация: данные в России и локальный Whisper
Расшифровать запись, не отдавая её в облако, можно бесплатно: сборка faster-whisper держит large-v3 примерно в 4,5 ГБ видеопамяти, а с квантованием int8 считает и на процессоре. Второй путь — российский сервис, который не отправляет аудиофайл за границу.
Вариант 1: российский сервис. Аудио и транскрипты Сонара хранятся на нашем сервере в России; расшифровка и разметка по спикерам считаются там же, на нашей видеокарте, а не в чужом облаке. Конспект и задачи по тексту расшифровки собирает внешняя языковая модель — аудио ей не передаётся. Мы не обучаем на ваших данных собственные модели. Срок хранения аудио зависит от тарифа — актуальные сроки указаны на странице тарифов; текст, конспект и задачи остаются бессрочно.
Вариант 2: своя машина. Whisper ставится командой pip install faster-whisper и запускается локально. Сегодня чаще берут не large-v3, а large-v3-turbo: 809M параметров вместо 1550M и четыре слоя декодера вместо тридцати двух — то есть заметно легче на том же железе. Есть и графические обёртки для тех, кто не хочет терминала (MacWhisper, Buzz), но цену MacWhisper мы не называем: в обзорах ходят две разные цифры, и первоисточник машинно не читается.
Чего у локального запуска нет: разметки по спикерам из коробки (pyannote ставится отдельно), архива, поиска и экспорта. Для разработчика это рабочий вариант, для юриста или врача — порог входа, который редко окупается.
Что говорит закон
У требования «данные не должны уезжать за границу» две разные нормы: статья 12 закона 152-ФЗ требует уведомить Роскомнадзор до начала трансграничной передачи, а часть 5 статьи 18 запрещает собирать данные россиян в зарубежные базы.
Первая норма означает, что загрузка записи в зарубежный сервис — это трансграничная передача, и уведомление о ней подаётся отдельно от общего уведомления об обработке данных. Вторая работает в редакции, действующей с 1 июля 2025 года. Обе относятся к оператору, то есть к компании, а не к читателю-физлицу, и обе проверены 8 сентября 2026 года — закон правился трижды за полтора года, так что перед решением стоит смотреть свежую редакцию. Подробный разбор — в статье о том, что говорит 152-ФЗ о записях и расшифровках.
С чего начать
Развилка простая: разовый файл — бесплатный инструмент на сайте, до 20 минут на файл и до 50 минут в сутки; поток встреч — кабинет и бот; чувствительная запись — локальная модель на своём компьютере.
Для разового файла ничего заводить не нужно: расшифровать аудио в текст онлайн можно без регистрации, аудио удаляется сразу после распознавания. Для регулярного потока заводится аккаунт: на бесплатном тарифе Старт — 90 минут записи в месяц, без карты и без срока. Дальше идёт фиксированная подписка без поминутной доплаты — состав тарифов и цены смотрите на странице тарифов.
У Сонара три входа в один и тот же архив: веб-кабинет в браузере, приложение на iPhone и Apple Watch и бот в Telegram — голосовое можно переслать прямо боту, он вернёт конспект и задачи в тот же чат. Оплата в рублях через ЮКассу, картой или через СБП.
Частые вопросы
Как сделать расшифровку аудио в текст бесплатно?
Три рабочих способа. Первый — бесплатный инструмент на сайте Сонара: файл до 20 минут, без регистрации, до 50 минут в сутки, аудио удаляется сразу после распознавания. Второй — бесплатные тарифы сервисов: у Сонара на Старте 90 минут в месяц без карты, у Speech2Text — 180 минут при регистрации плюс 15 минут каждый день (проверено 8 сентября 2026). Третий — Whisper на своём компьютере: pip install faster-whisper, бесплатно и без интернета.
Чем транскрибация отличается от стенограммы?
Транскрибация — процесс перевода речи в текст, стенограмма аудиозаписи — документ. Юридический вес стенограмме даёт не точность распознавания, а человек, который её оформил и подписал: в судебном заседании, на слушаниях, в нотариальной практике. Машинная расшифровка не становится стенограммой ни при каком проценте точности — она становится ею после того, как ответственный человек вычитал текст и принял его.
Какая нейросеть лучше расшифровывает аудио на русском?
Зависит от типа записи, и это не отговорка. В независимом замере февраля 2026 года GigaAM v3 дала 3,3% WER против 7,9% у Whisper large-v3-turbo. У того же автора в июне 2026 на студийной речи разрыв исчез: 7,28% у Whisper-turbo против 7,89% у GigaAM — сам он называет это статистическим паритетом; на записях с YouTube обе модели ушли за 26%. На телефонии выигрывает специализированная T-one: 8,63% против 19,39%. Проверяйте на своих файлах.
Как расшифровать видео в текст?
Загрузить видеофайл в сервис расшифровки: звуковую дорожку он вынет сам через ffmpeg. Сонар принимает mp4, m4v, mov, mkv, webm и avi, конвертировать заранее не нужно. Ролик из интернета сначала скачивают (yt-dlp или десктопный загрузчик), затем грузят файл. Автосубтитры YouTube — быстрый, но черновой вариант: без разметки по спикерам и с ломаными именами и терминами.
Что такое диаризация и зачем она нужна?
Диаризация аудио — это разметка записи по спикерам: кто говорит в какой момент. Технически её делает отдельная нейросеть, чаще всего pyannote: она сравнивает голоса и расставляет метки «Спикер 1», «Спикер 2». Имена не угадываются — их назначает человек после расшифровки. Для двух собеседников разметка почти безошибочна, на четырёх и больше похожих голосах путается. В Сонаре она работает на платных тарифах, на Старте выключена.
Сколько стоит расшифровка часа аудио?
От нуля до нескольких сотен рублей — разброс объясняется режимом обработки, а не брендом. У Yandex SpeechKit единица тарификации — отрезок 15 секунд: 0,1626 ₽ синхронно и 0,0381 ₽ в отложенном режиме, то есть час записи по нашему пересчёту — около 39 ₽ и около 9 ₽ (проверено 8 сентября 2026). У Speech2Text сверх бесплатного лимита — 4 ₽ за минуту (проверено 8 сентября 2026), в нашем пересчёте это 240 ₽ за час. У Сонара поминутной доплаты нет: пакет минут входит в подписку, тарифы.
Безопасно ли загружать конфиденциальные записи в облако?
Зависит от того, где стоит сервер и что написано в вашей корпоративной политике. Загрузка в зарубежный сервис — это трансграничная передача по статье 12 закона 152-ФЗ: оператор обязан подать в Роскомнадзор отдельное уведомление до её начала. Аудио и транскрипты Сонара хранятся на сервере в России; расшифровка идёт на нашей видеокарте, а конспект по тексту собирает внешняя языковая модель. Если политика запрещает любые сторонние сервисы, остаётся локальный Whisper: файл не выходит за пределы вашей машины.
Источники
- Сбер: GigaAM-v3 — открытая модель распознавания русской речипубликация 15 декабря 2025 года, лицензия MIT, средний WER 6,7% (RNN-T) и 7,4% (CTC) по семи открытым наборам данных
- Хабр: сравнение моделей распознавания русской речи (февраль 2026)независимый замер: GigaAM v3 — 3,3%, Whisper large-v3-turbo — 7,9%, Vosk — 13,0%
- Хабр: повторный замер тех же моделей (июнь 2026)на студийной речи Whisper-turbo 7,28% против 7,89% у GigaAM; предобработка меняет WER на 6-9 пунктов
- Hugging Face: карточка модели openai/whisper-large-v3цифр WER по русскому в карточке нет; заявлено только снижение ошибок на 10-20% против large-v2
- faster-whisper — репозиторий проектаlarge-v3 примерно в 4,5 ГБ видеопамяти в fp16, работает и на процессоре
- Yandex SpeechKit: тарифы распознаванияединица тарификации — отрезок 15 секунд: 0,1626 ₽ синхронно, 0,0381 ₽ в отложенном режиме
- Speech2Text: тарифы180 бесплатных минут при регистрации плюс 15 минут в день, сверх лимита 4 ₽ за минуту
- КонсультантПлюс: статья 12 закона 152-ФЗ (трансграничная передача)уведомление Роскомнадзора подаётся отдельно, до начала передачи
- Яндекс 360: конспект встречи от Алисы Про в Телемостедоступен только организациям на тарифах Яндекс 360, записи хранятся 24 часа